Temas base para entender EasyChatBot
Embeddings, RAG, Esencia del bot y cómo decidir qué conviene en tu caso, sin jerga innecesaria.
Volver al índice de documentación
¿Prefieres un recorrido guiado?
Si quieres publicar un asistente mínimo sin profundizar en teoría, empieza por Tu primer bot sencillo: crear el bot, añadir contexto o esencia, y probar en el chat de prueba.
¿Cuándo usar RAG y cuándo no?
RAG (búsqueda en tu base de conocimiento) tiene sentido cuando tienes mucha información: miles de productos, cientos de páginas, catálogos que sincronizas por API o crawling. El sistema parte el contenido en fragmentos, los indexa y, en cada pregunta, recupera solo los trozos más relevantes.
Si tu negocio se resume en pocas páginas de texto fijo — una carta de restaurante, una tabla de precios corta, horarios y diez preguntas frecuentes — no necesitas montar un catálogo enorme ni una intención de búsqueda para todo. Suele ser más simple y barato pegar ese texto en la Esencia del bot, en un contexto TEXT corto o en una intención Instrucción.
flowchart TD
    Pregunta["Cuántas piezas distintas debe recordar el bot"]
    subgraph poco [Poco contenido fijo]
        Essence["Esencia del bot"]
        Instruction["Instrucción MCP"]
        SmallText["Contexto TEXT corto"]
    end
    subgraph mucho [Mucho contenido]
        Crawl["Crawling o API Context"]
        Index["Indexación en fragmentos"]
        RAG["Intención RAG Search"]
    end
    Pregunta -->|Unas pocas docenas de líneas o menos| poco
    Pregunta -->|Cientos o miles de SKUs páginas filas| mucho
    Crawl --> Index --> RAG
| Situación | Enfoque recomendado |
|---|---|
| Marketplace o tienda con miles de referencias, muchas categorías, fichas que cambian | Crawling o API Context + intenciones con RAG Search. Ver acción RAG Search. |
| Restaurante con carta de unas veintena de platos y bebidas | Esencia del bot (pega la carta y horarios). Opcional: intención Instrucción para el menú del día. Sin crawling masivo. |
| Clínica o estudio con una página de servicios y FAQ | Esencia + Instrucción. RAG solo si más adelante añades decenas de artículos o páginas. |
Ejemplos ficticios (para orientarte)
- Mercado Río Claro — marketplace con ~8.000 productos de vendedores distintos: crawling + RAG para «¿tienen…?» y comparativas; API Connect si necesitas precio o stock en vivo.
- Casa Lúmen — tienda de lámparas, ~2.500 SKUs y muchas variantes: API Context o crawl + RAG; combina con Query Rewriting si el visitante habla de «la del anuncio azul».
- Bistró La Alacena — carta corta: todo en Esencia del bot, sin indexar un catálogo artificial.
Más escenarios en Casos de uso.
Esencia del bot
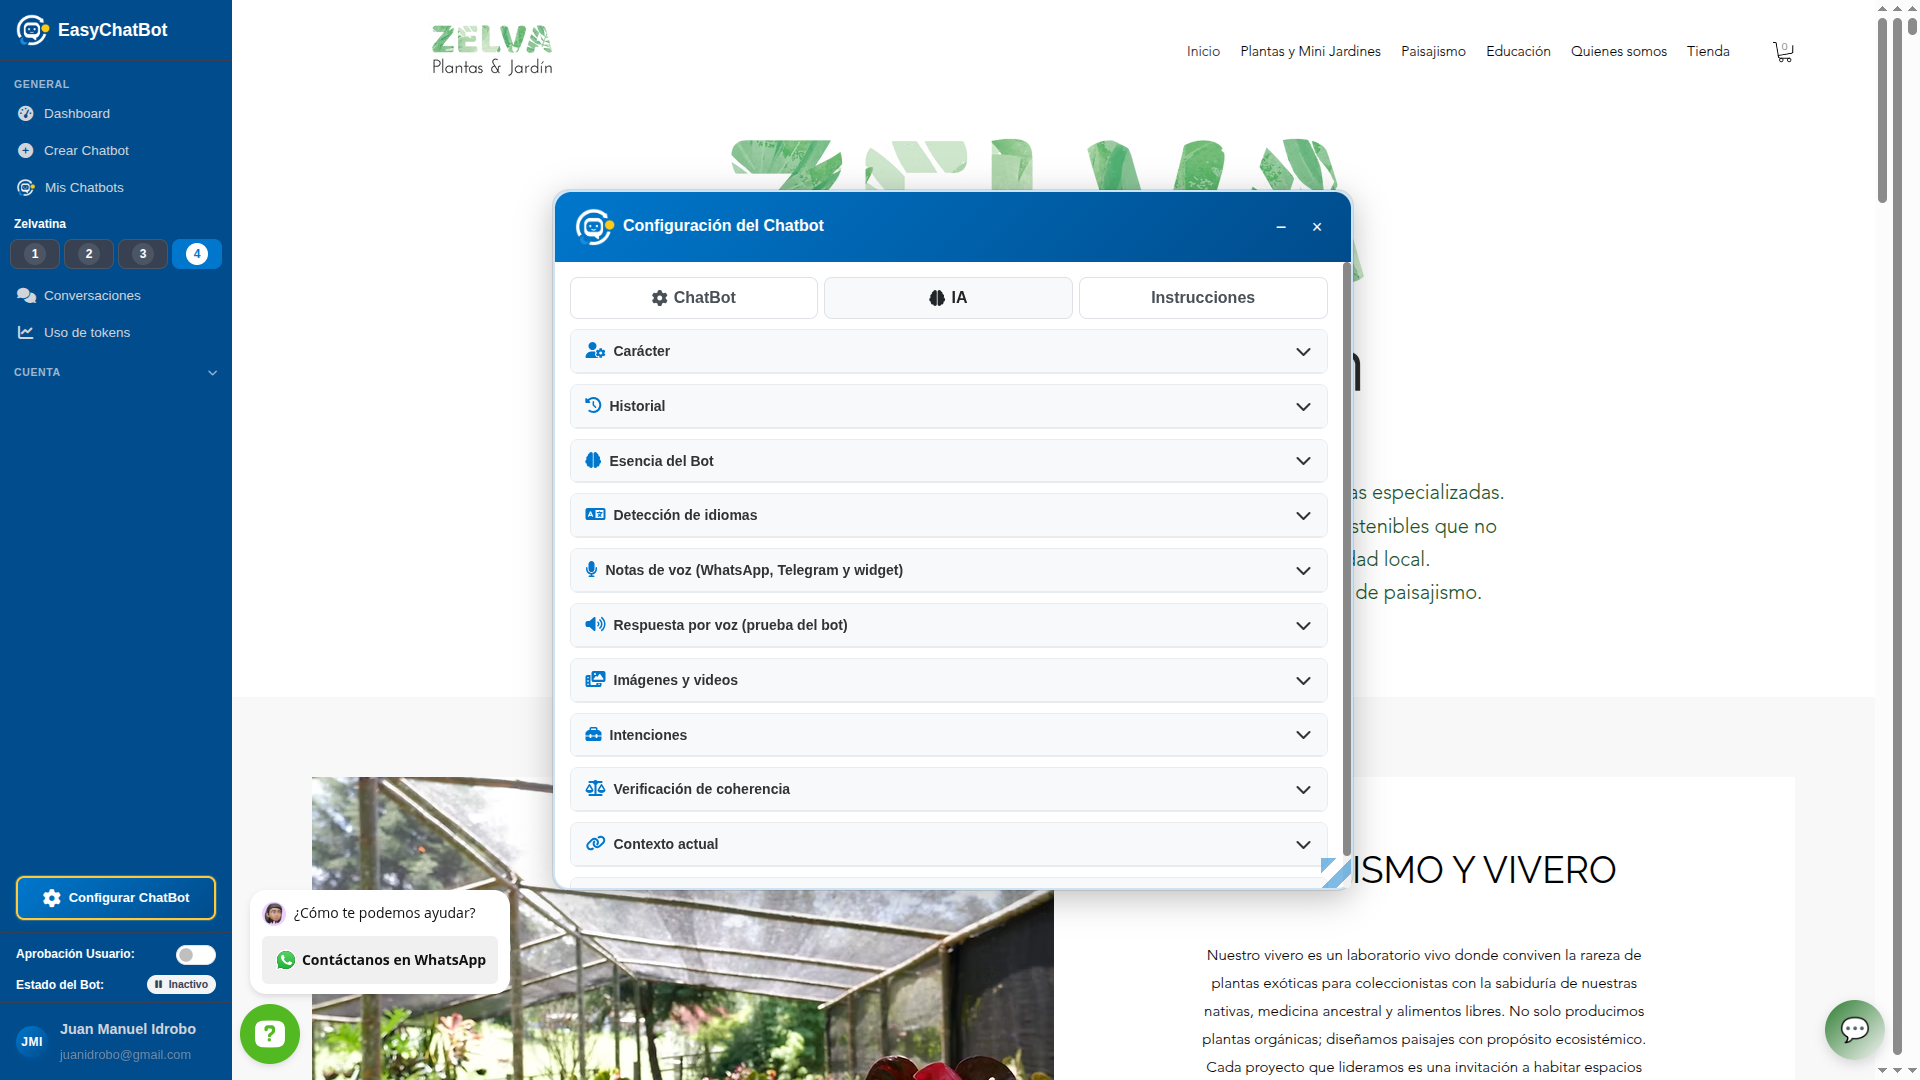
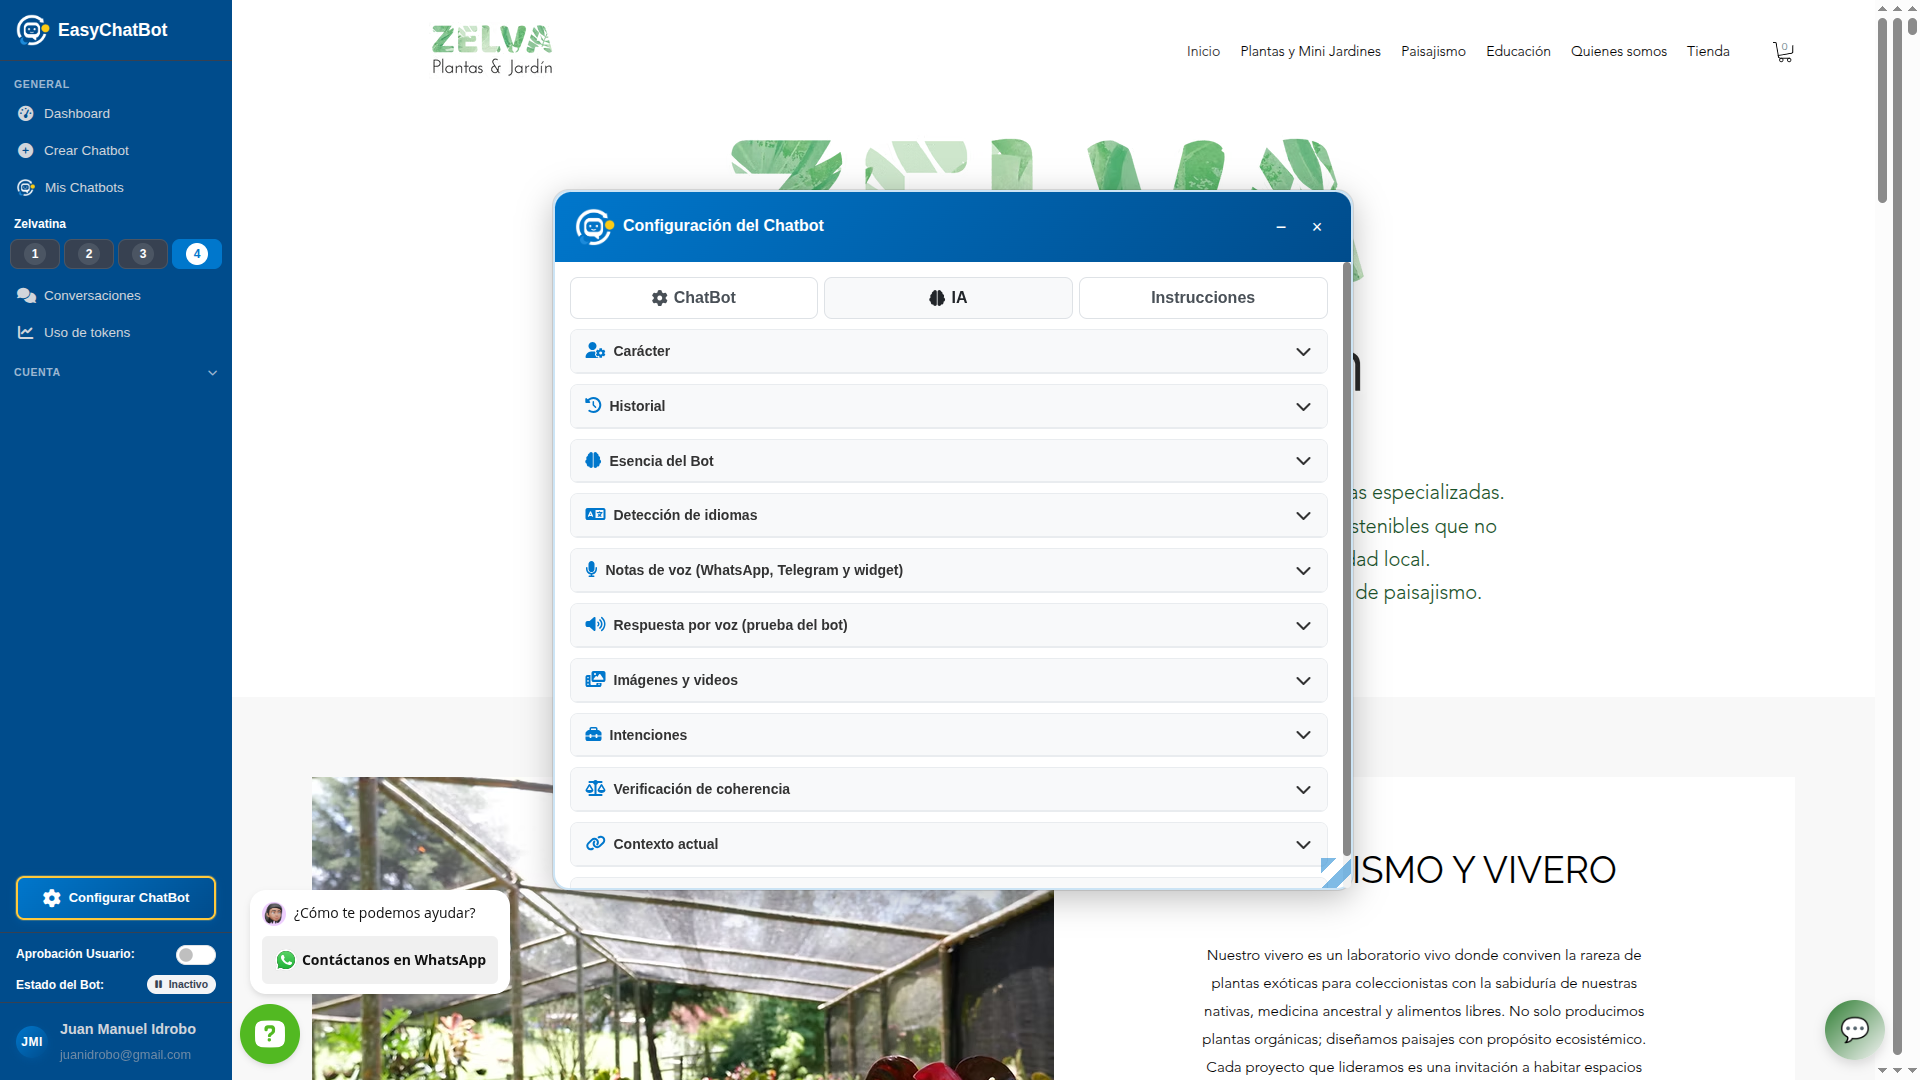
En Configurar bot → Esencia del Bot escribes el prompt que define el tono, el comportamiento y el conocimiento base del asistente. Ese texto viaja en el contexto del modelo en cada conversación (a diferencia de RAG, que añade fragmentos solo cuando una intención lo pide).
Úsala cuando el contenido es estable y breve: quién eres, cómo hablas, menú, políticas cortas, datos de contacto. No intentes volcar ahí un catálogo entero de miles de filas: el modelo no «memoriza» un inventario completo de esa forma; para eso está la base de conocimiento y RAG.
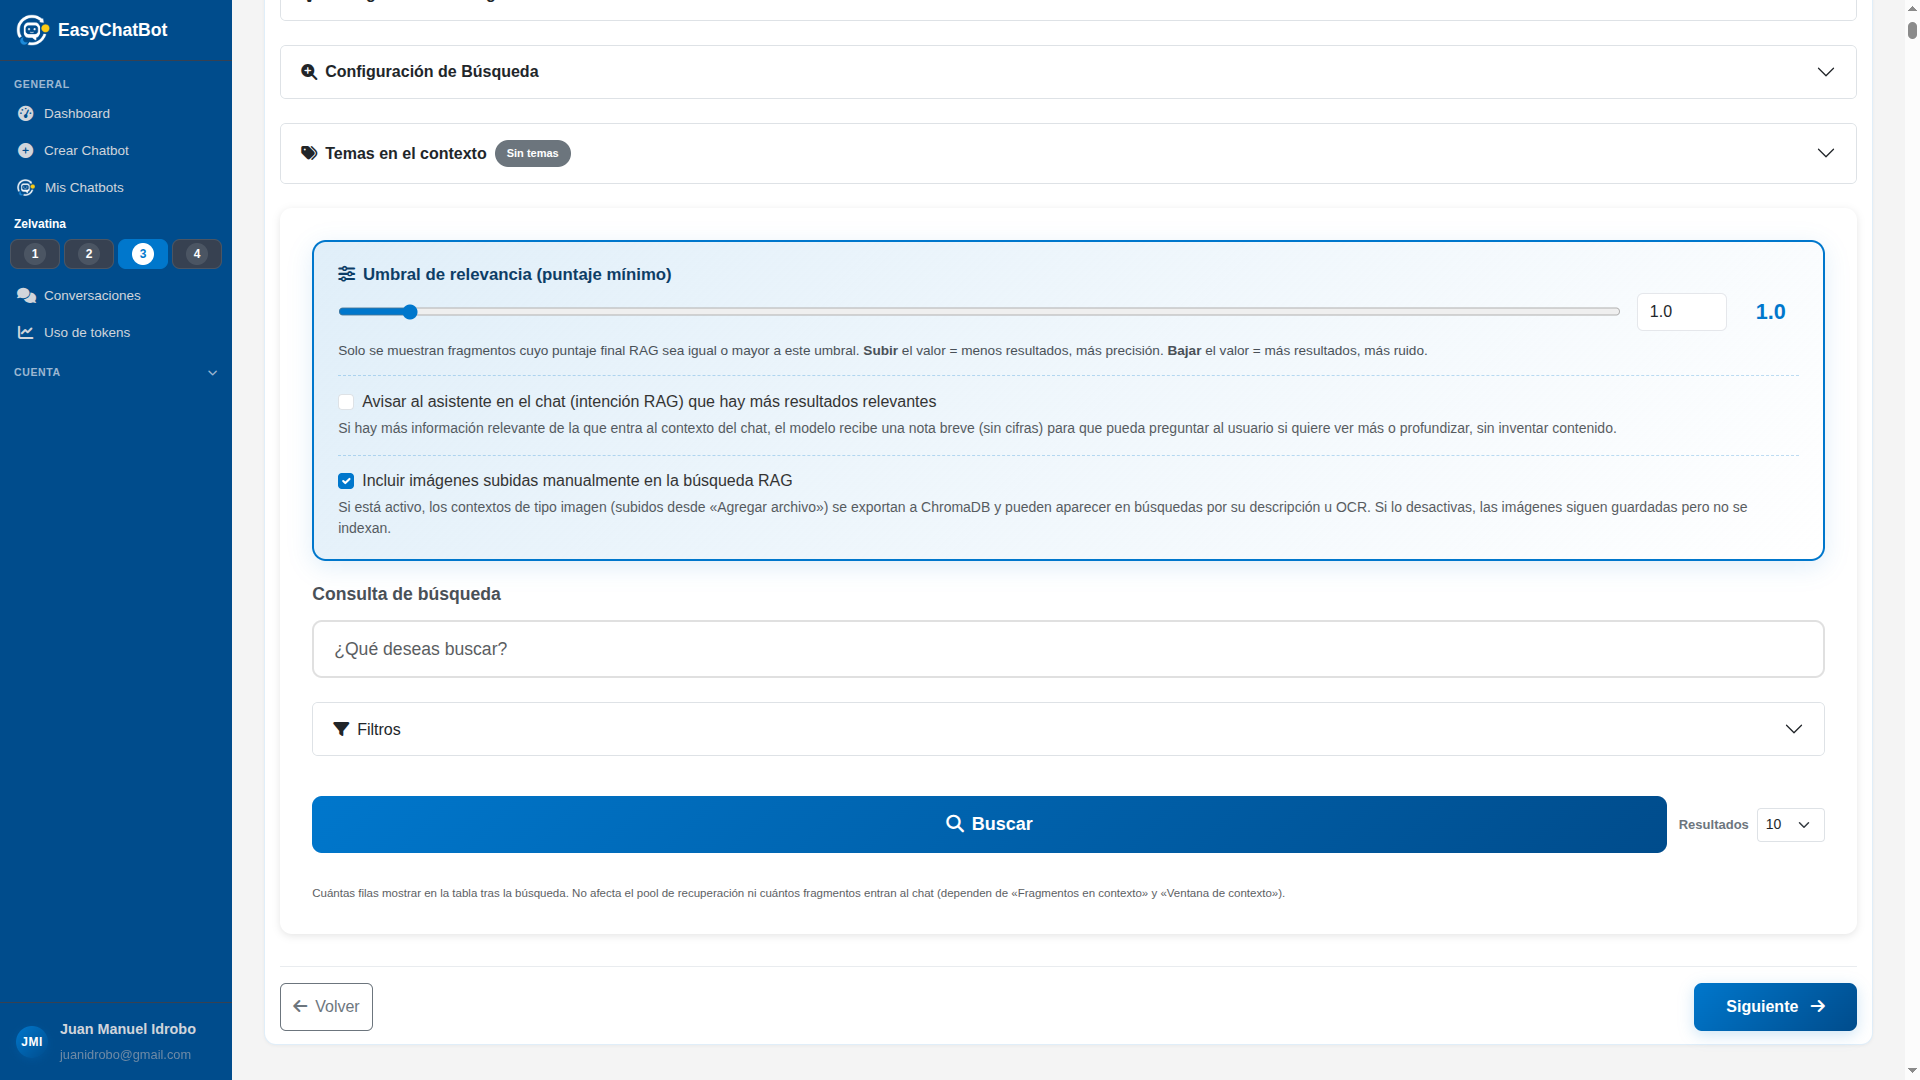
Guía visual completa del panel en la página de acción RAG Search.
Por qué importa esto
EasyChatBot une dos piezas: tu contenido (páginas que crawleas, textos que configuras, esencia) y un modelo de lenguaje que redacta respuestas. Los embeddings y el RAG son el puente cuando el contenido es grande: permiten que el modelo «lea» trozos relevantes de tu material en cada conversación, en lugar de inventarse datos o depender solo del entrenamiento general del modelo.
¿Qué es un embedding?
Un embedding es una lista de números (un vector) que resume el significado de un texto de forma que el ordenador pueda compararlo con otros textos. No hace falta entender los números: lo útil es que textos con ideas parecidas quedan «cerca» en ese espacio numérico, y textos distintos, «más lejos».
Así el sistema puede decir «esta pregunta del usuario se parece a este párrafo de tu web» sin buscar palabras exactas: busca por similitud semántica.
flowchart LR
    texto["Texto_o_fragmento"]
    modelo["Modelo_de_embeddings"]
    vector["Vector_numerico"]
    guardar["Guardado_para_buscar"]
    texto --> modelo --> vector --> guardar
En la práctica
- El mismo tipo de modelo convierte en embedding tanto fragmentos de tu contenido como la pregunta del usuario.
- La búsqueda recupera los fragmentos cuyos vectores están más cerca del vector de la pregunta.
¿Qué es RAG?
RAG (generación aumentada con recuperación) significa: antes de que el modelo escriba la respuesta, el sistema recupera trozos de texto relevantes de una base de conocimiento y los incluye en el contexto. La respuesta se «aumenta» con ese material recuperado.
Sin RAG en la intención, el modelo se apoya en la esencia, el historial del chat y su entrenamiento general. Con RAG, cuando el visitante activa la intención adecuada, puede razonar sobre tu contenido actualizado — pero solo sobre los fragmentos recuperados en ese turno, no sobre todo el inventario a la vez.
flowchart TB
    pregunta["Pregunta_del_usuario"]
    embQ["Embedding_de_la_pregunta"]
    buscar["Buscar_fragmentos_similares"]
    contexto["Textos_recuperados"]
    prompt["Prompt_con_contexto"]
    llm["Modelo_de_lenguaje"]
    resp["Respuesta_al_usuario"]
    pregunta --> embQ --> buscar --> contexto --> prompt --> llm --> resp
Cómo encaja en EasyChatBot
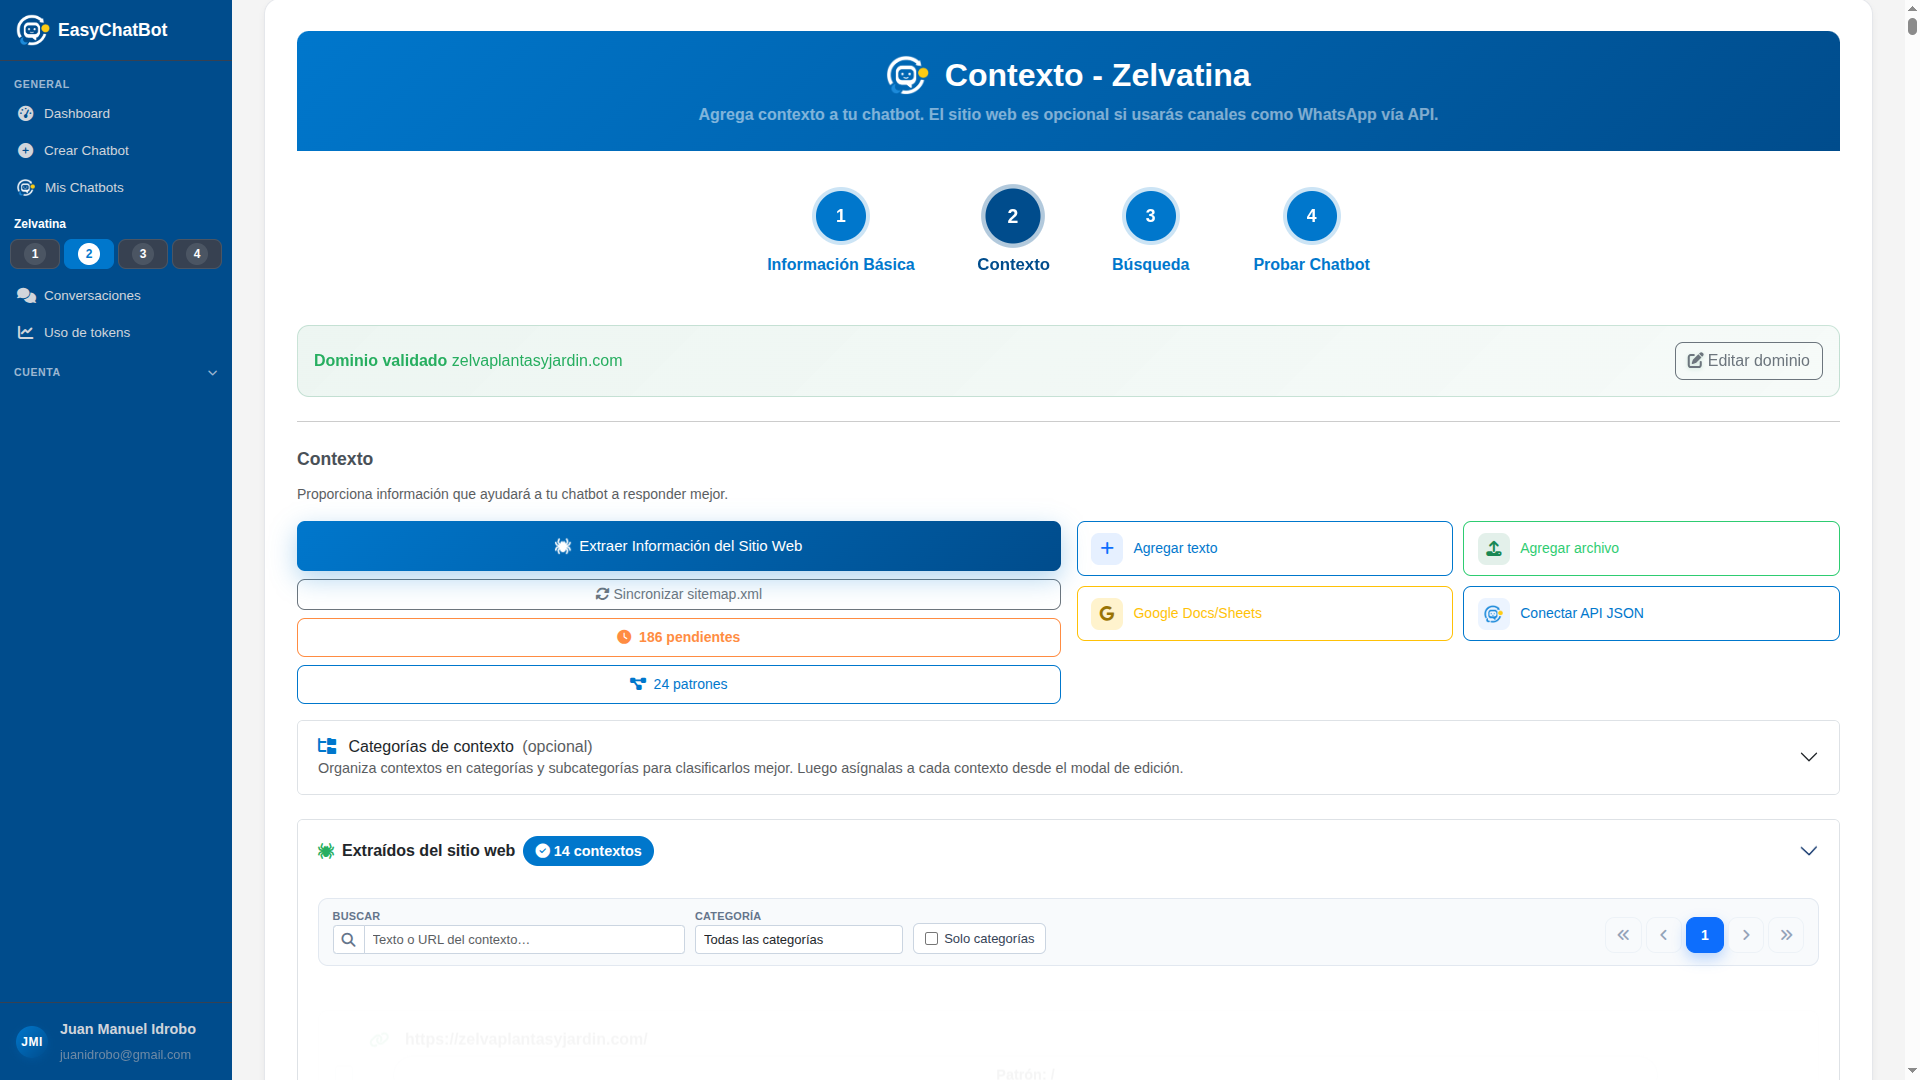
El crawling, los contextos manuales y las fuentes API generan textos; EasyChatBot los parte en fragmentos, calcula un embedding por fragmento y los guarda en la base de conocimiento del bot. Cuando una intención activa la acción RAG Search, se embeddea la consulta, se buscan los fragmentos más cercanos y el modelo recibe esos textos junto con la conversación.
Más detalle sobre el origen del contenido: Crawling y contexto.
sequenceDiagram
    participant V as Visitante
    participant ECB as EasyChatBot
    participant BK as Base_de_conocimiento
    participant M as Modelo_de_lenguaje
    V->>ECB: Mensaje en el chat
    ECB->>ECB: Detectar intencion y acciones
    ECB->>BK: Busqueda por embedding
    BK-->>ECB: Fragmentos relevantes
    ECB->>M: Prompt con contexto recuperado
    M-->>ECB: Texto de respuesta
    ECB-->>V: Respuesta
